J’ai refondu le système d’information d’une entreprise répartie sur deux sites, organisés en Hub and Spoke : le siège à Paris et une succursale à Nantes. L’infrastructure de départ était vieillissante, l’objectif était de la reprendre pour qu’elle soit mieux sécurisée, automatisée et capable d’encaisser un incident. Je me suis appuyé sur le principe du Zero Trust, sur le durcissement des systèmes Windows et Linux selon les guides de l’ANSSI, sur l’automatisation des déploiements avec Ansible et sur une supervision continue via un SIEM.
1. Sécurisation des flux et interconnexion : Stormshield et PKI
La première phase a porté sur les flux, aussi bien entre les deux sites que pour les collaborateurs en télétravail, avec des pare-feux Stormshield. Avant toute configuration logicielle, j’ai repris le câblage et le plan d’adressage pour isoler le réseau WAN en 192.36.253.0/24 des réseaux LAN, 10.0.1.0/24 côté Paris et 10.0.2.0/24 côté Nantes.
Le lien entre Paris et Nantes devait être fiable, puisqu’il allait porter la réplication de l’Active Directory. J’ai donc monté le tunnel en IKEv2 avec AES-GCM-256 et abandonné la clé pré-partagée, trop fragile, au profit de deux mécanismes complémentaires :
- Authentification par certificat en cross-trust : J’ai déployé une PKI sur les deux sites, avec les autorités CA-OPENBANK et CA-NANTES-PROXY. Chaque pare-feu dispose d’une identité serveur générée et signée, ce qui rend l’usurpation de son identité très difficile. Un prérequis pour que ça fonctionne : la synchronisation horaire entre les deux firewalls, que j’ai donc synchronisés sur mon AD. En effet, si l’écart de temps entre les deux dépasse la tolérance, le certificat est rejeté pendant la négociation car sa date est considérée comme invalide.
- Résistance post-quantique : j’ai ajouté par-dessus une clé pré-partagée post-quantique, définie sur “obligatoire” et conforme à la RFC 8784, pour anticiper les attaques du type “Store Now, Decrypt Later”.
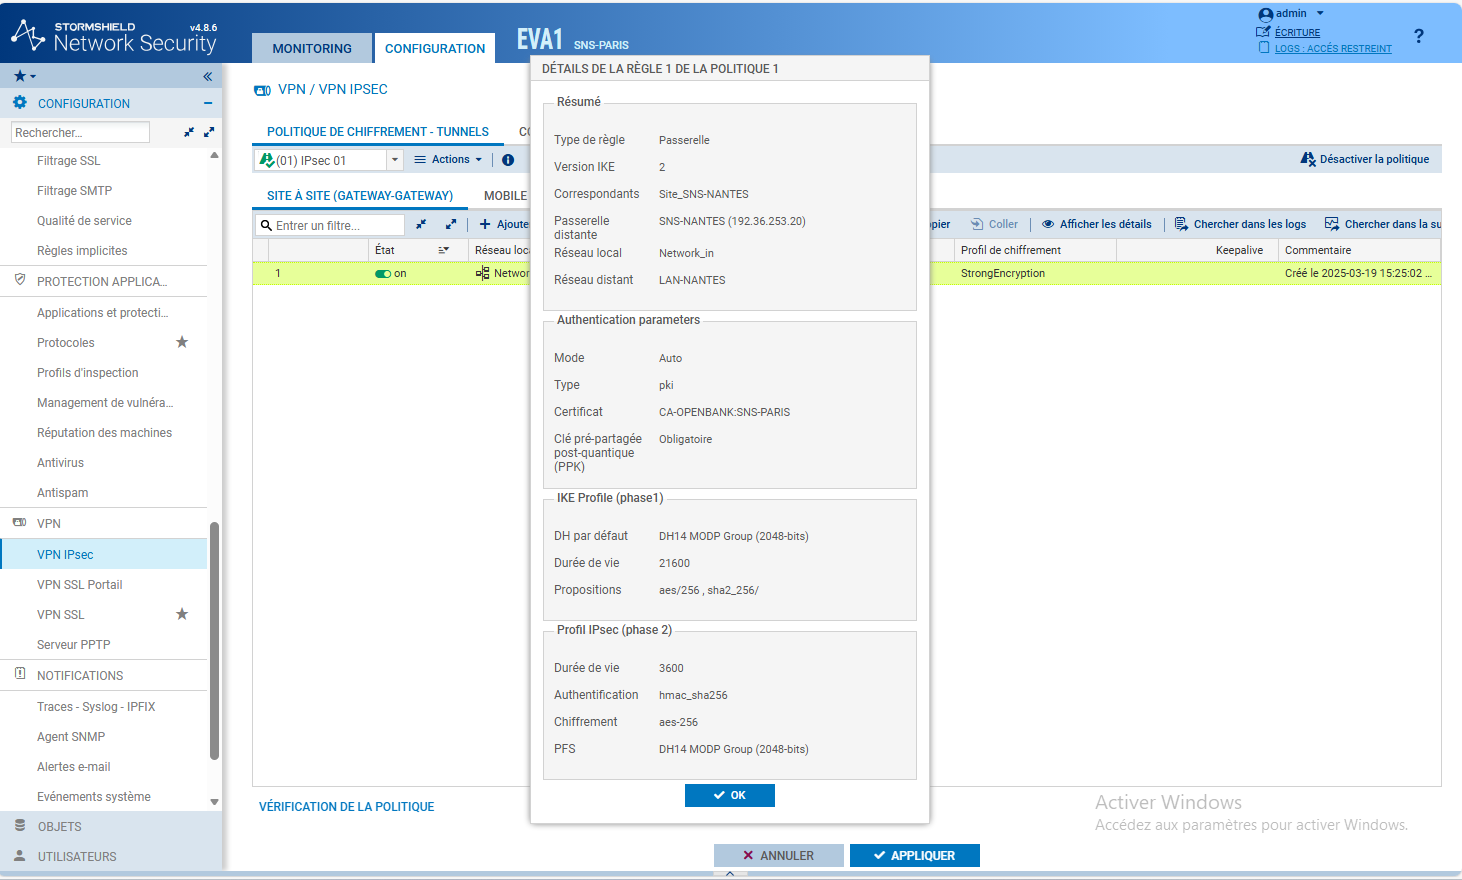
Pour verrouiller le tunnel, j’ai écrit des règles de filtrage ASQ avec la clause “via IPsec VPN tunnel”, ce qui empêche une machine sur Internet d’usurper une adresse IP locale et d’attaquer le LAN. Les logs ont confirmé le montage des phases IKE SA et IPSEC SA.
J’ai ensuite mis en place une inspection SSL pour analyser les flux applicatifs et bloquer les catégories de sites à risque : contenus illégaux, pornographie, warez.
- La contrainte cryptographique : pour ouvrir une connexion HTTPS, le pare-feu doit générer de faux certificats à la volée. L’import d’un simple certificat public au format .crt renvoyait l’erreur 02c00e00, la clé privée n’étant pas associée. J’ai donc exporté l’autorité de certification au format PKCS#12, en .p12 avec mot de passe d’export, pour donner au moteur proxy sa capacité de signature.
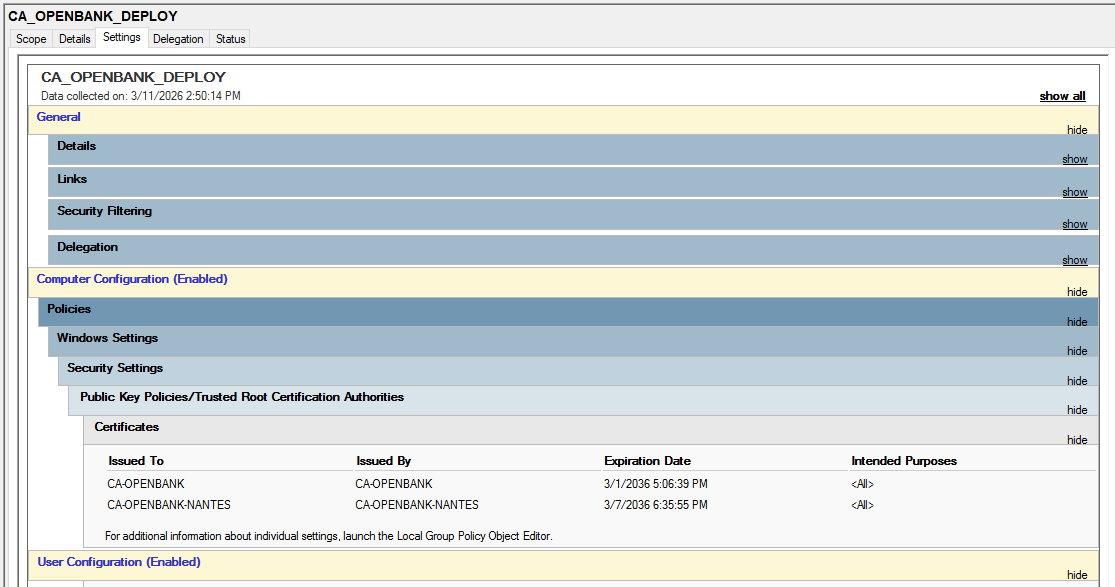
- Déploiement sans coupure : pour éviter que l’inspection HTTPS ne provoque l’alerte “Site non sécurisé” sur tous les navigateurs du parc, j’ai déployé la partie publique de CA-OPENBANK dans le magasin “Autorités de certification racines de confiance” de chaque poste, via la GPO CA_OPENBANK_DEPLOY.
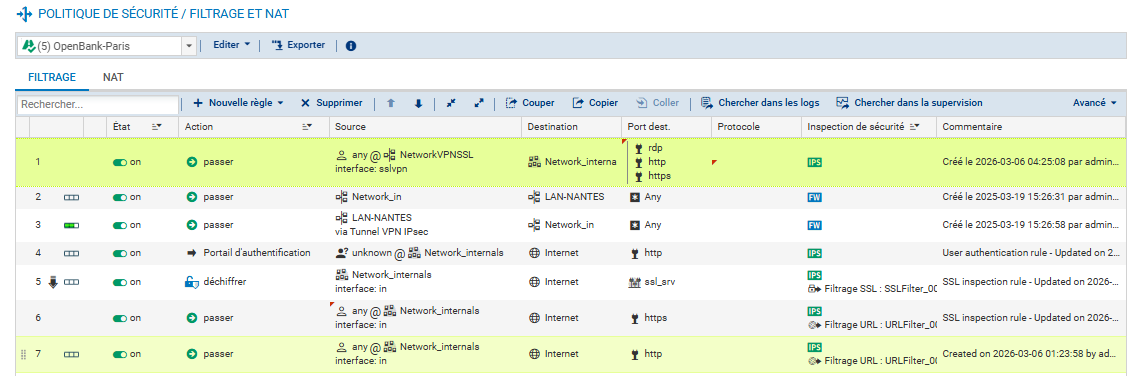
L’architecture du filtrage. Stormshield traite les couches réseau les unes après les autres, j’ai donc construit une matrice en cascade pour éviter les conflits entre moteurs :
- une règle d’inspection SSL, action “déchiffrer”, pour ouvrir l’enveloppe TLS en couche 6 ;
- une règle de filtrage-NAT, action “passer”, avec le profil d’inspection URLFilter_00 pour lire le contenu en clair et bloquer la requête au besoin, en couche 7.
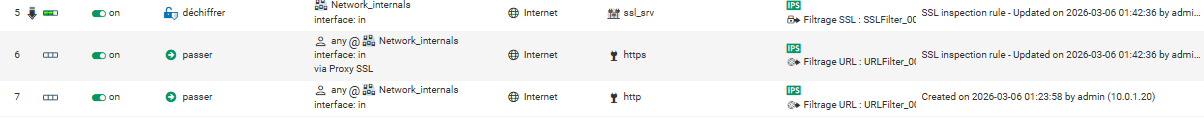
J’ai ajouté les catégories a filter :
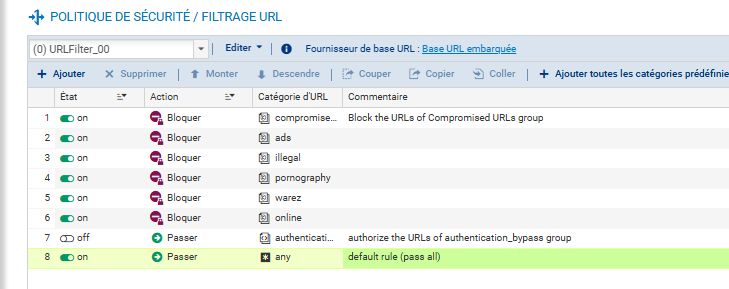
Et voici donc la matrice de filtrage finale :
2. Accès distant : ZTNA et MFA
J’ai repris l’accès au réseau des télétravailleurs. Un conflit d’allocation apparaissait dans les pools OpenVPN, je l’ai résolu en créant des pools réseau distincts pour les flux UDP et TCP du service.
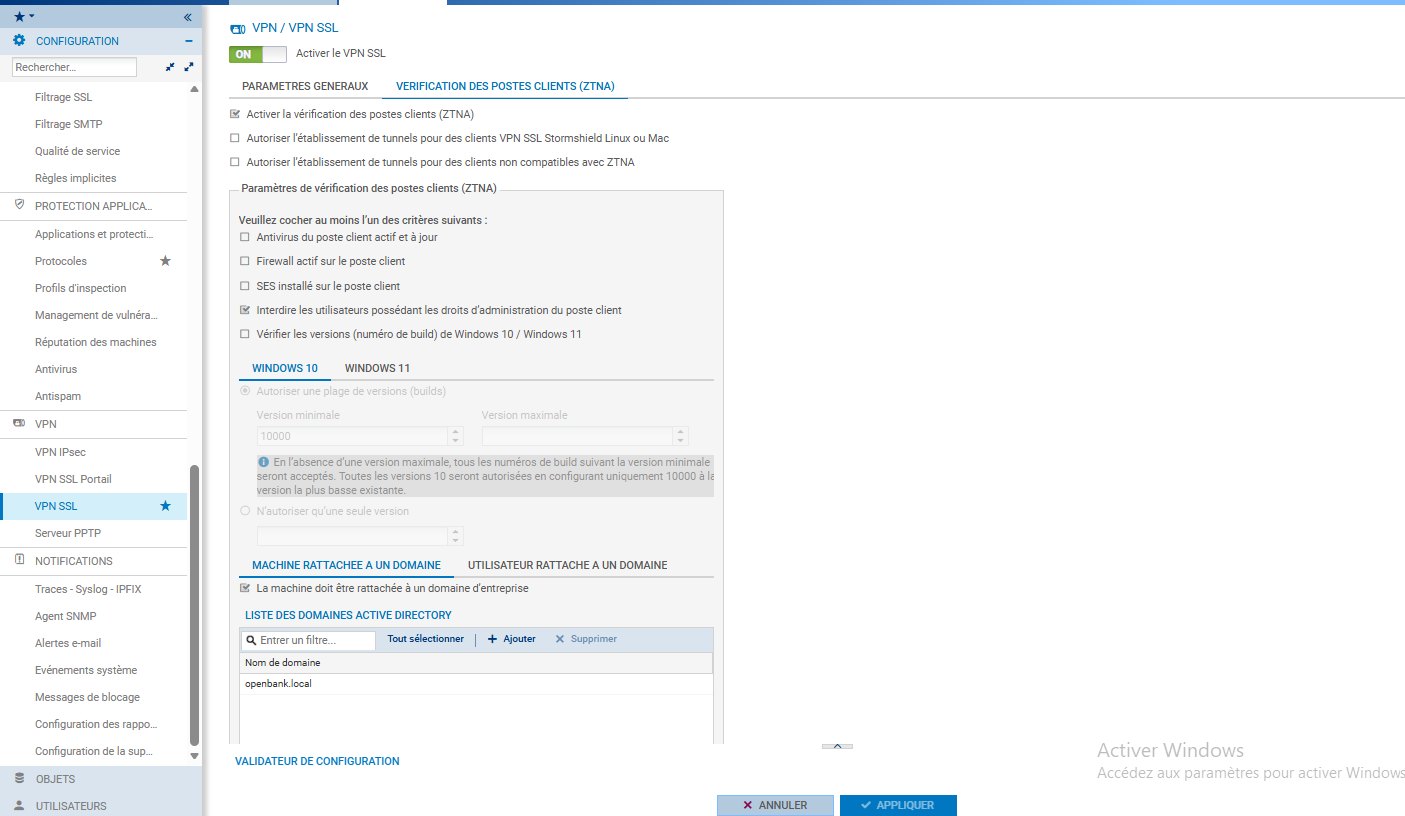
L’approche périmétrique classique ne suffisait plus, j’ai donc ajouté une couche ZTNA. Contrairement à un client standard, le client VPN officiel embarque des sondes de conformité du poste. Le tunnel ne monte que si la machine valide en temps réel deux conditions :
- elle appartient au domaine Active Directory openbank.local ;
- l’utilisateur n’est pas administrateur local de son poste.
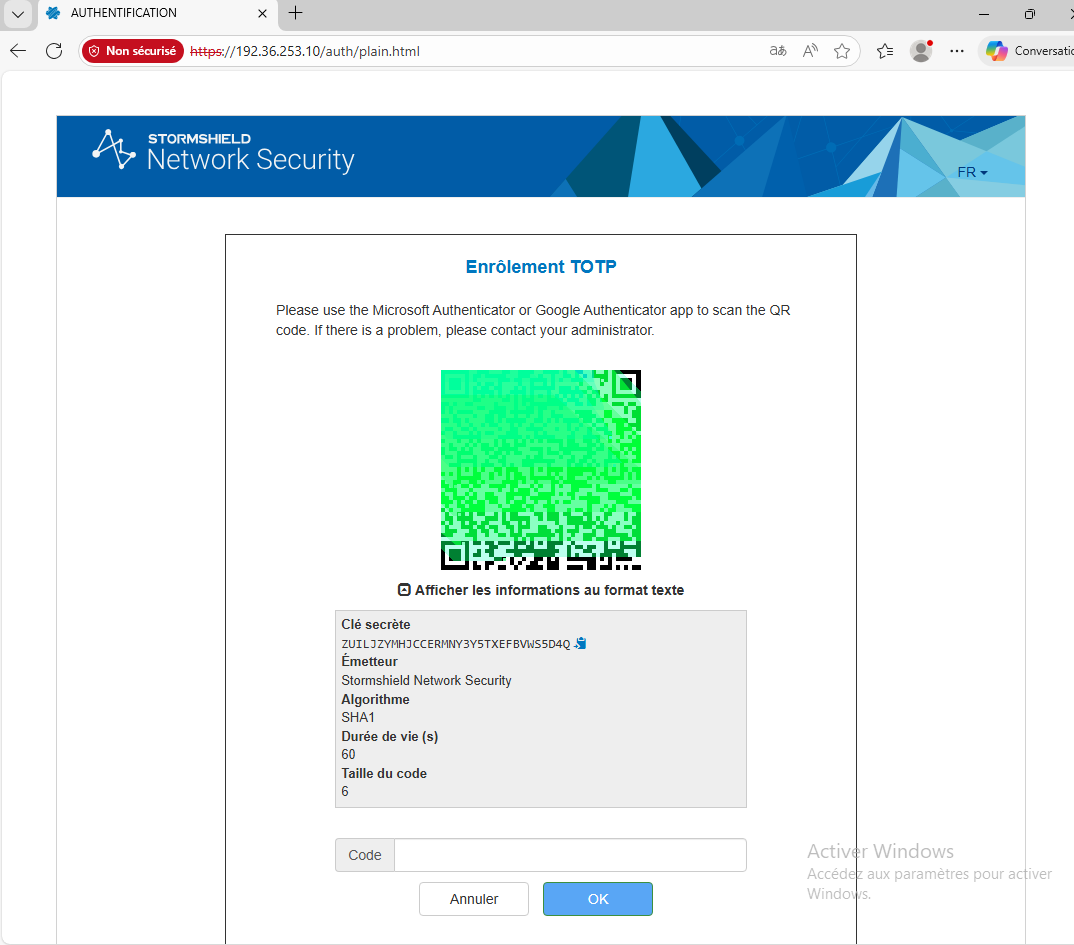
J’ai enfin couplé une authentification multifacteur TOTP à l’annuaire LDAP. L’utilisateur passe donc par trois vérifications : l’état de sa machine avec le ZTNA, son mot de passe de domaine via LDAP, puis le code à usage unique sur son smartphone.
3. Durcissement des postes et restructuration de l’Active Directory
Une fois le réseau verrouillé par le VPN ZTNA, je suis passé aux postes de travail et aux identités. Un attaquant qui réussirait à contourner le réseau ne doit pas pouvoir élever ses privilèges en local, ni se déplacer latéralement.
Les politiques appliquées suivent les référentiels de l’ANSSI, le guide d’hygiène informatique et les recommandations AD et Linux. J’ai restructuré l’Active Directory pour en finir avec les affectations de droits directes.
3.1. Refonte de l’Active Directory : AGDLP et tiering
- Modèle AGDLP : j’ai réécrit les autorisations sur les partages de fichiers. Les utilisateurs sont placés dans des groupes globaux par métier, eux-mêmes imbriqués dans des groupes de domaine local par ressource. Le modèle passe bien à l’échelle et évite les tempêtes d’entrées/sorties sur les serveurs de fichiers lors des mouvements RH, puisque les ACL NTFS n’ont plus besoin d’être recalculées.
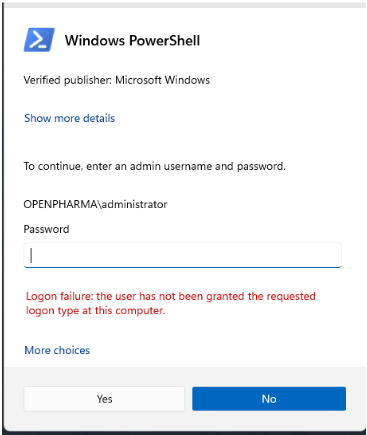
- Tiering hybride : pour limiter le vol d’identifiants et les attaques de type Pass-The-Hash, j’ai cloisonné l’administration. Les comptes de l’équipe technique sont découpés selon leur criticité : T0 pour le domaine, T1 pour les serveurs, T2 pour les postes. Les connexions descendantes sont interdites par GPO.
3.2. Durcissement Windows par GPO
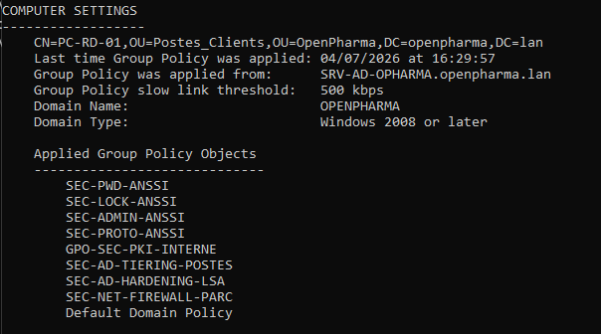
J’ai placé les postes Windows 11 et les serveurs dans des unités d’organisation dédiées, pour appliquer un durcissement fin sans perturber la production. Les principales GPO déployées :
- Protection LSA et Credential Guard, SEC-AD-HARDENING-LSA : les secrets d’authentification, hashs NTLM et tickets Kerberos, sont isolés dans un conteneur virtualisé géré par l’hyperviseur. Le processus lsass.exe tourne en mode protégé avec RunAsPPL=1, ce qui bloque l’extraction de mots de passe par un outil comme Mimikatz, même avec les droits SYSTEM.
- Révocation des droits locaux, SEC-ADMIN-ANSSI : j’ai utilisé les groupes restreints pour purger le groupe Administrateurs local de chaque poste et retirer ces privilèges aux utilisateurs standards.
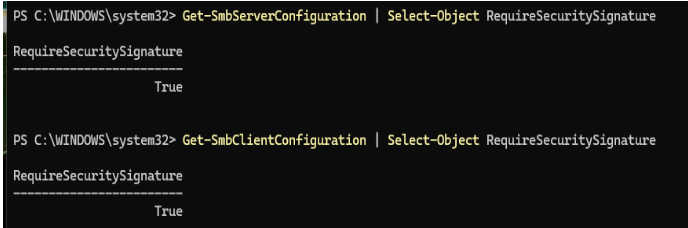
- Nettoyage réseau, SEC-PROTO-ANSSI : désactivation des protocoles de diffusion obsolètes LLMNR et NBT-NS, et signature SMB rendue obligatoire côté client et serveur pour bloquer les attaques de relais NTLM.
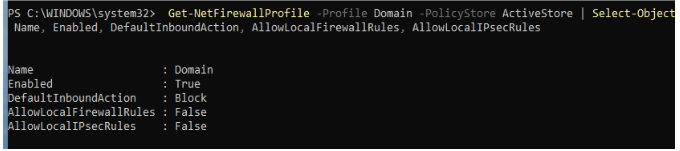
- Zero Trust sur les postes, SEC-NET-FIREWALL-PARC : j’ai durci les trois profils du pare-feu Windows Defender, domaine, privé et public, avec un refus par défaut sur tous les flux entrants non sollicités, et j’ai désactivé la fusion des règles locales pour que rien ne vienne assouplir la politique depuis le poste. Ça empêche une porte dérobée de s’installer durablement, ça bloque les mouvements latéraux, et les paquets abandonnés sont journalisés pour nourrir le SIEM.
4. Sécurisation du serveur Linux critique
Le serveur Linux qui héberge les applications métier a été durci avec une suite de 5 scripts Bash, écrits pour être idempotents et commentés :
- Authentification locale, 01_sec_ssh_pam.sh : connexion root interdite en SSH avec PermitRootLogin no, et durcissement des modules PAM pour imposer des mots de passe solides.
- Fichiers critiques et services, 02_sec_fs_services.sh : désactivation des services inutiles comme cups, bluetooth et rpcbind pour réduire la surface d’attaque, et passage du fichier
/etc/shadowen chmod 400. - Pile réseau du noyau, 03_sec_network_sysctl.sh : paramètres sysctl pour activer les SYN cookies et bloquer le routage source ainsi que l’usurpation d’adresse IP.
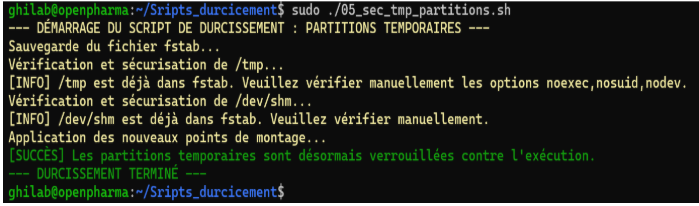
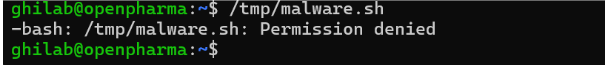
- Verrouillage des partitions, 05_sec_tmp_partitions.sh : modification du fstab pour monter
/tmpet/dev/shmavec les optionsnoexec,nosuidetnodev. Un attaquant ne peut donc plus exécuter un fichier déposé dans ces répertoires.
5. Traçabilité avec Auditd et plan de reprise d’activité avec Veeam
La sécurité préventive n’a de sens que si elle s’accompagne d’une traçabilité fiable et d’une capacité de restauration en cas de compromission.
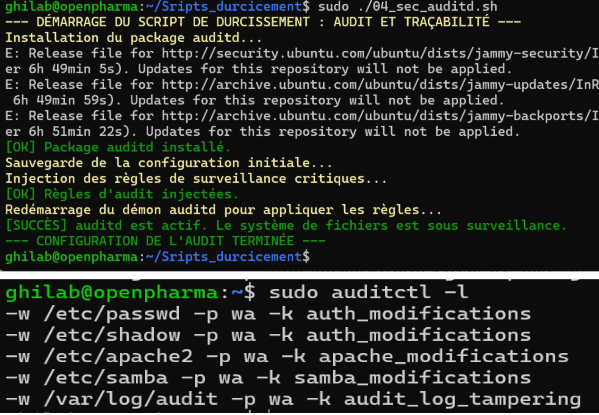
A. Traçabilité avec Auditd sous Linux
Le script 04_sec_auditd.sh met en place le démon d’audit système. J’y ai configuré des règles bas niveau, des hooks noyau, pour intercepter les appels d’écriture et les changements d’attributs, chmod et chown, sur les répertoires des services exposés comme Apache2 et Samba. Toute action de maintenance devient attribuable, et une tentative de persistance malveillante se voit tout de suite.
B. Résilience et PRA avec Veeam Backup & Replication
J’ai déployé une architecture de sauvegarde Veeam, avec une base PostgreSQL en arrière-plan. Mettre en place la stratégie de sauvegarde a demandé de traiter plusieurs contraintes, à la fois d’architecture et de sécurité :
- Séparation des ressources : stocker les sauvegardes sur le volume du système n’avait pas de sens, j’ai donc revu la topologie de l’hyperviseur. J’ai dédié un second disque de 100 Go en NTFS au dépôt de sauvegarde. Pour limiter le risque ransomware, j’ai configuré ce répertoire en partage masqué,
SAUVEGARDE$, via PowerShell : il devient invisible lors d’un scan réseau, NetBIOS ou WS-Discovery. - Le problème de timeout VSS : au démarrage, un job en mode Entire Computer saturait les entrées/sorties disque et déclenchait un timeout RPC. Le service VSS essayait de geler le disque de destination, le stockage Veeam, en même temps que le disque source. Ce comportement tient à l’architecture même de VSS, mais dans mon cas il était accentué par les limites de l’environnement virtuel, un hyperviseur de type 2. Sur une infrastructure de production avec des baies SAN ou NVMe, la bande passante IOPS aurait absorbé ce gel sans provoquer de timeout.
- La solution : plutôt que de désactiver la protection, j’ai reconfiguré le job en Volume-Level, ciblé sur la seule partition système, en gardant le traitement transactionnel applicatif VSS actif. Les clichés restent cohérents, sans se heurter aux limites matérielles du labo.
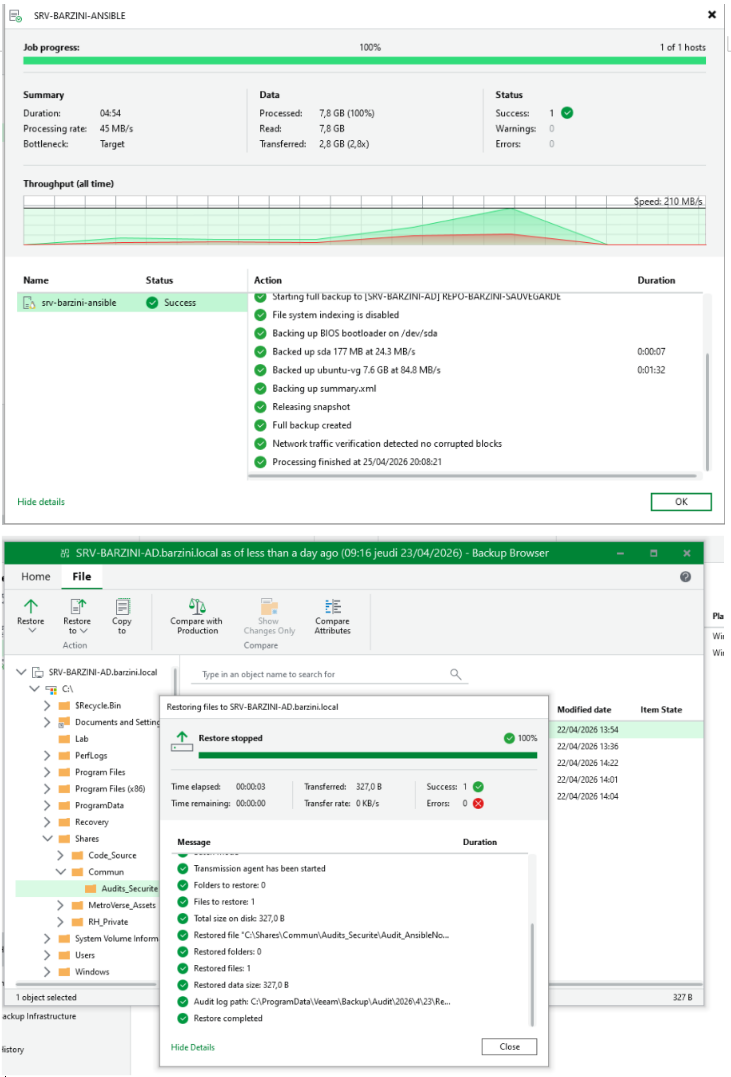
- Validation du PRA : j’ai testé la chaîne de secours avec une restauration au niveau fichier. L’archive chiffrée
.vbka été montée dynamiquement en mémoire pour récupérer un rapport d’audit CSV supprimé, ce qui a confirmé que la stratégie fonctionnait.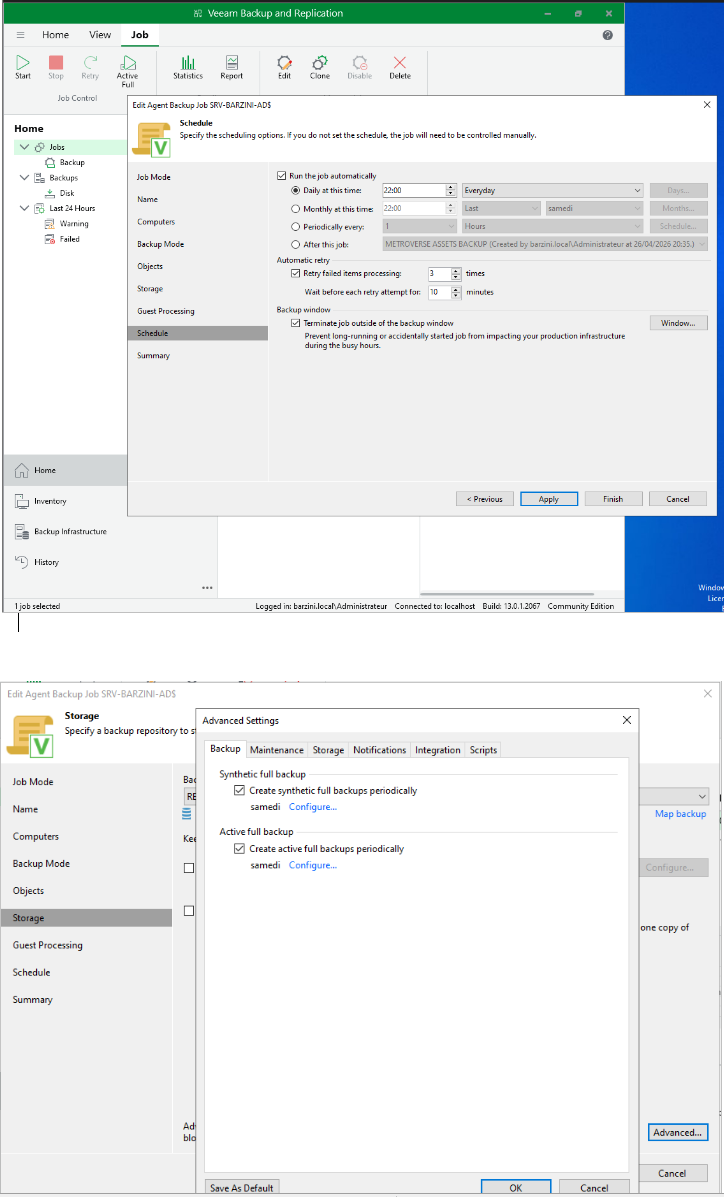
6. Automatisation de l’infrastructure avec Ansible
La dernière phase a consisté à automatiser l’administration, à protéger les données métier et à gagner de la visibilité sur les menaces comme sur la disponibilité des services. Pour administrer un parc mixte Windows et Linux sans repasser par des actions manuelles, j’ai déployé un nœud de contrôle Ansible sur un serveur Ubuntu 24.04. Sa mise en place a demandé de régler plusieurs points bloquants.
A. Le nœud de contrôle et la synchronisation horaire
Intégrer un serveur Linux dans un écosystème Microsoft impose quelques précautions. J’ai isolé l’environnement Python dans un venv, pour respecter la PEP 668 et cloisonner les dépendances cryptographiques comme pywinrm. J’ai aussi soigné la synchronisation horaire : le démon systemd-timesyncd est forcé sur l’horloge du contrôleur de domaine. Dans un environnement Active Directory, un décalage de plus de 5 minutes fait détruire les trames par le sous-système LSA de Windows, et Ansible ne pourrait plus s’authentifier ni en Kerberos ni en NTLM.
B. Transport WinRM et problème du double-saut
Pour piloter les postes Windows 11 à travers les pare-feux, j’ai activé WinRM avec Enable-PSRemoting, un port d’écoute en TCP/5985 et le transport NTLMv2 autorisé. Le vrai point dur a été le double-saut réseau, lié à la restriction de délégation propre à NTLM.
- Le problème : NTLMv2 ne permet pas à un serveur A, ici Ansible, de s’authentifier sur un client B puis de demander à B de réutiliser ces identifiants pour rebondir vers un serveur C, un partage AD par exemple. Le protocole ne transporte tout simplement pas les identifiants au-delà du premier saut.
- La solution : j’ai joint les postes au domaine pour basculer sur Kerberos. Contrairement à NTLM, Kerberos gère nativement la délégation grâce à ses tickets de service, ce qui permet au serveur A de rebondir vers C sans ce blocage.

C. Optimisation des audits
En écrivant les playbooks d’audit des logiciels installés, j’ai volontairement écarté la classe WMI Win32_Product. L’interroger force le service Windows Installer à revalider chaque MSI installé, ce qui sature les entrées/sorties disque du client. Les scripts lisent donc directement les clés de registre sous HKLM:\SOFTWARE\Microsoft\Windows\CurrentVersion\Uninstall, ce qui permet d’auditer tout le parc sans gêner les utilisateurs.
D. Gestion des secrets avec Ansible Vault et exécution par cron
Laisser les identifiants d’administration en clair dans le fichier d’inventaire hosts.ini était une faille évidente. J’ai mis en place Ansible Vault pour sortir ces variables sensibles, mots de passe et clés, et les chiffrer en AES-256 dans un fichier YAML dédié, windows.yml. Pour que les playbooks de mise à jour et d’audit tournent la nuit via cron sans intervention, j’ai généré une clé maître .vault_pass.txt, verrouillée en chmod 600, et déclaré son chemin absolu dans le bloc [defaults] de ansible.cfg avec la directive vault_password_file. Le moteur déchiffre la configuration en mémoire au moment de l’exécution, sans rien demander au clavier.

E. Logs et débogage
Par défaut, cron s’exécute dans un sous-shell non interactif /bin/sh qui ignore les variables d’environnement comme $PATH. J’ai donc programmé les tâches avec des chemins absolus. Pour garder de la visibilité, j’ai activé la directive log_path dans la configuration Ansible. En cas de panne, un problème de transport WinRM par exemple, les drapeaux de verbosité maximale -vvv écrivent dans ansible_execution.log les traces brutes des plugins de connexion, ce qui rend le diagnostic beaucoup plus rapide.

7. Chiffrement et protection des données
Pour protéger les données sensibles de l’entreprise, données R&D et fichiers de production, j’ai mis en place un chiffrement au niveau des fichiers.
- Ansible a poussé l’agent Cryptomator sur le parc Windows, sans intervention, via le module
win_package. - J’ai créé un coffre réseau sur le partage de production
\\SRV-AD\COMMON$. - Résultat : l’utilisateur travaille sur un lecteur virtuel monté dynamiquement en mémoire sur son poste. Le serveur de fichiers, lui, ne reçoit, ne stocke et ne sauvegarde que des données chiffrées en AES-256 avec une arborescence masquée. Même exfiltrées, ces données restent inexploitables.
8. Supervision et SIEM avec Wazuh
L’infrastructure était en place, restait à garantir sa disponibilité et à surveiller les comportements suspects, y compris internes.
Supervision de la disponibilité. J’ai configuré des sondes pour détecter les pannes avant qu’elles n’atteignent la production, avec des seuils d’alerte Warning et Critical sur les métriques clés :
- charge CPU via
load_averageet occupation disque viadf -h; - nombre de sessions SSH interactives, pour repérer les accès non autorisés ;
- disponibilité des processus applicatifs critiques,
apache2etmariadb.
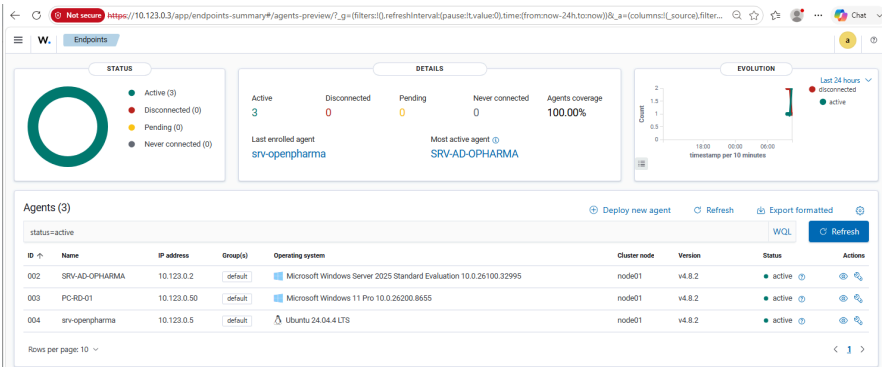
SIEM. J’ai déployé une architecture Wazuh complète avec Manager, Indexer et Dashboard. Des agents installés sur l’ensemble des postes et serveurs, Windows comme Linux, remontent les journaux en temps réel sur le port TCP 1514, chiffré en TLS.
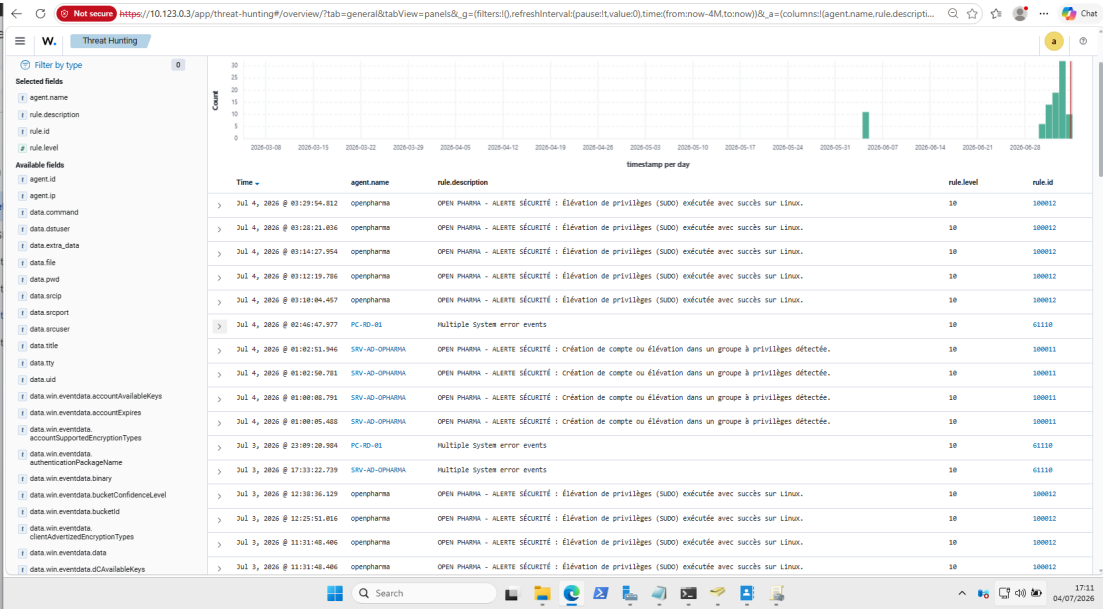
J’ai écrit 4 règles de corrélation personnalisées dans local_rules.xml pour détecter des scénarios précis :
- Règle 100010, force brute : 5 échecs d’authentification consécutifs, EventID 4625, en moins de 120 secondes.
- Règle 100011, persistance : détection de l’EventID 4720 pour la création d’un compte local et du 4732 pour l’ajout au groupe Administrateurs.
- Règle 100012, élévation de privilèges sous Linux : analyse de
auth.logpour tracer les exécutions réussies viasudo. - Règle 100013, intégrité des fichiers : alerte critique dès qu’un changement modifie le hachage SHA-256 de
/etc/shadow.
Conclusion
Ce projet m’a fait concevoir, déployer et maintenir une infrastructure hybride Windows et Linux de bout en bout.
En passant d’une architecture fondée sur la confiance implicite à un modèle Zero Trust, avec RBAC et tiering AD, les principaux vecteurs d’attaque sont fermés. Ansible garantit l’idempotence des configurations et supprime les écarts entre machines, pendant que Wazuh permet de réagir tôt sur les incidents. L’infrastructure n’est plus seulement fonctionnelle : elle est auditable, elle se remet d’un incident, et elle tient face aux menaces actuelles.